相關性強度
直覺上,我們可以觀察下列圖形來「看」兩個變數是否「一起變動」。
- 資料集 A:x 與 y 一起變動,關係看起來很強。
- 資料集 B:大致往上走;x 與 y 的關聯看起來較鬆散。
- 資料集 C:像是隨機散佈;x 與 y 看起來不一起變動,彼此無關。
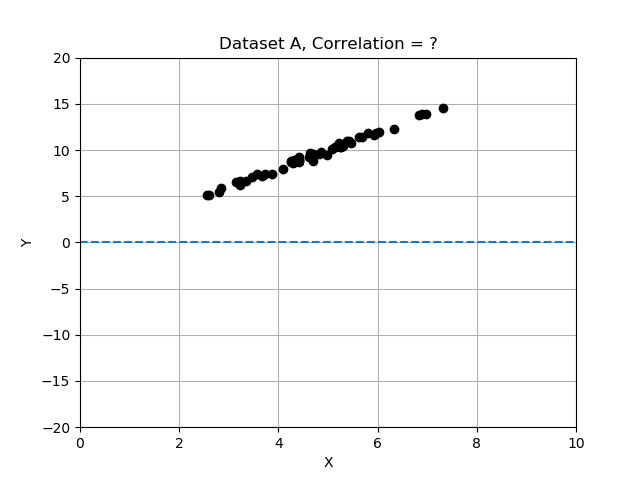
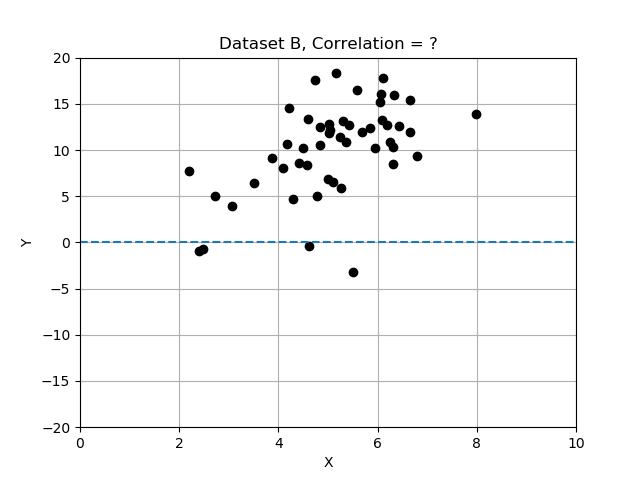
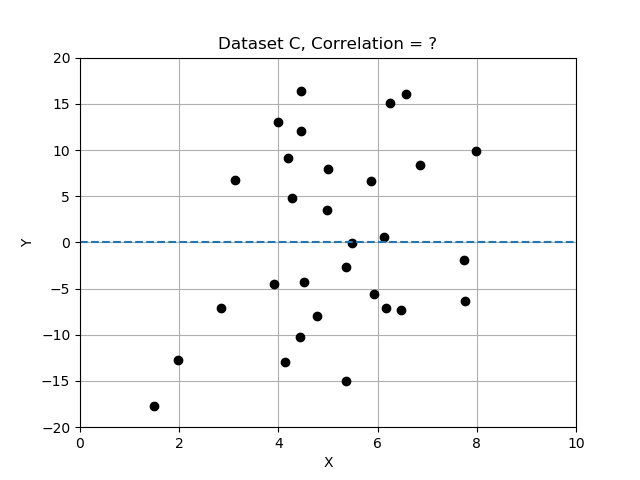
回想一下,偏差是與平均數之間的差,而我們會以標準差來做標準化(把偏差除以標準差)。在這個練習中,你將透過計算相關性來比較這 3 個資料集,並判斷哪一個資料集的變數 x 與 y 的相關性最強。請使用提供的資料表 data_sets,這是由多筆紀錄組成的字典,每筆都有 'name'、'x'、'y'、'correlation' 這些鍵。
本練習屬於課程
Python 線性建模入門
練習說明
- 完成
correlation()的函式定義,使用x與y的「標準化偏差乘積」的平均值。 - 走訪
data_sets,用correlation(record['x'], record['y'])計算並儲存每個相關性。 - 先執行到目前為止的程式碼(也就是 for 迴圈的最後),並查看輸出。哪個資料集的相關性最強?
- 將相關性最強的資料集名稱(
data_sets['A']、data_sets['B']、或data_sets['C'])指定給變數best_data。
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Complete the function that will compute correlation.
def correlation(x,y):
    x_dev = x - np.____(x)
    y_dev = y - np.____(y)
    x_norm = x_dev / np.____(x)
    y_norm = y_dev / np.____(y)
    return np.____(x_norm * y_norm)

# Compute and store the correlation for each data set in the list.
for name, data in data_sets.items():
    data['correlation'] = ____(data['x'], data['y'])
    print('data set {} has correlation {:.2f}'.format(name, data['correlation']))

# Assign the data set with the best correlation.
best_data = data_sets['____']