主成分分析(PCA)
在前面 2 個章節中,你已經看過多種降低資料集維度的方法,包括正則化與特徵選擇。在機器學習面試中,能清楚解釋降維的不同面向很重要。大型資料集計算時間長,而資料中的雜訊也可能使結果產生偏誤。
降維的一種方法是主成分分析(principal component analysis,PCA)。它能透過建立新的特徵,保留資料集中最有用的資訊,同時移除多重共線性,進而有效縮小資料規模。在本練習中,你將使用 sklearn.decomposition 模組,對 diabetes 資料集的特徵進行 PCA,並將目標變數 progression 分離。
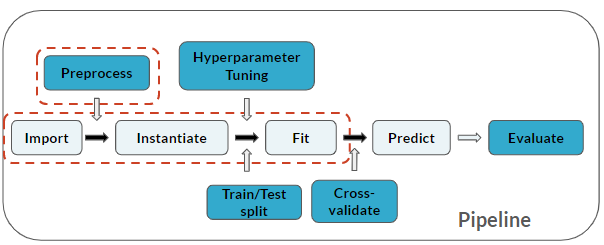
你在 pipeline 中目前的位置:
本練習屬於課程
用 Python 練習機器學習面試題
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Import module
from ____.____ import ____

# Feature matrix and target array
X = ____.____('____', axis=1)
y = ____['____']