Z 分數標準化
在上一個練習中,你已經計算過 Z 分數來處理離群值。在機器學習面試中,另一個常見問題是:Z 分數還會用在哪裡?它們常用於在建立模型之前,先對資料做縮放。
在這個練習中,你會使用影片課程中介紹過、來自 sklearn.preprocessing 的函式,將 loan_data 資料集中的數值特徵欄位標準化。回想一下,這會把資料縮放為平均數為 0、標準差為 1。
sklearn.preprocessing 模組已為你匯入。
Pipeline 快照:
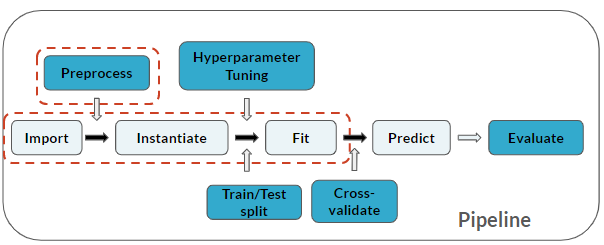
本練習屬於課程
用 Python 練習機器學習面試題
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Subset features
numeric_cols = ____.____(include=[____.____])
categoric_cols = ____.____(include=[____])