決策樹
在前面 3 個章節中,你已經學到一系列技巧,能協助你應對機器學習面試的多個面向。這一章將介紹各種方法,確保在機器學習面試中,你被要求建立或討論的任何模型都具有良好的泛化能力、能被正確評估,並且能在多個候選模型中做出適當選擇。
在這個練習中,你將針對 loan_data 資料集的決策樹進行超參數調校。
你會調整 min_samples_split(建立額外二元分裂所需的最小樣本數)以及 max_depth(你希望樹成長到的最大深度)。樹越深,分裂越多,因此能擷取到更多關於資料的資訊。
特徵矩陣 X 與目標標籤 y 已經替你匯入。
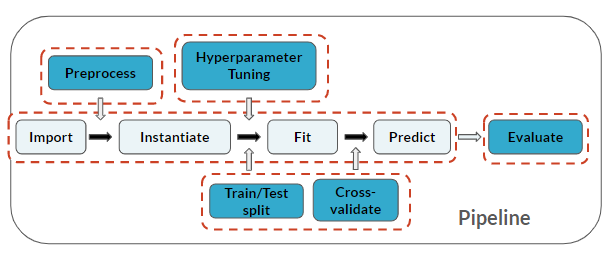
請注意,你再一次完整執行了機器學習流程中的所有步驟!
本練習屬於課程
用 Python 練習機器學習面試題
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Import modules
from sklearn.tree import ____
from sklearn.metrics import accuracy_score

# Train/test split
X_train, X_test, y_train, y_test = train_test_split(____, ____, test_size=0.30, random_state=123)

# Instantiate, Fit, Predict
loans_clf = ____()
loans_clf.____(____, ____)
y_pred = loans_clf.____(____)

# Evaluation metric
print("Decision Tree Accuracy: {}".format(____(____,____)))