透過特徵重要度進行特徵選擇
在上一個練習中,你練習了篩選式(filter)與包裝式(wrapper)方法在機器學習與面試情境中如何用於特徵選擇。這一題,你將在 diabetes 資料框上,使用以樹為基礎的機器學習演算法內建的特徵重要度,來實作特徵選擇方法。
雖然在 DataCamp 上只能示範其中幾種方法,但你可以參考 scikit-learn 官方網站上的優質文件,瞭解選擇特徵的其他作法。
特徵矩陣與目標陣列已分別以 X 和 y 的名稱存入你的工作空間。
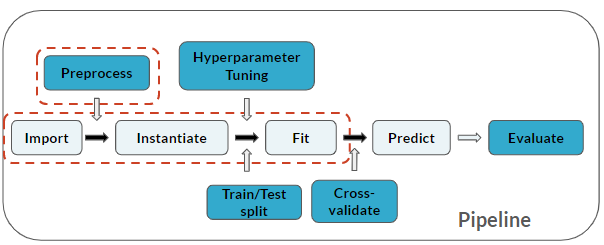
請記得,特徵選擇屬於前處理步驟:
本練習屬於課程
用 Python 練習機器學習面試題
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Import
from sklearn.ensemble import ____

# Instantiate
rf_mod = ____(max_depth=2, random_state=123,
              n_estimators=100, oob_score=True)

# Fit
rf_mod.____(____, ____)

# Print
print(diabetes.columns)
print(rf_mod.____)