訓練/測試分布
在機器學習面試中,你幾乎一定會處理訓練資料與測試資料。如前所述,若訓練與測試資料集的分布不同,模型效能可能會變差。
在本練習中,你將使用 sklearn.model_selection、seaborn 與 matplotlib.pyplot 的函式,將 loan_data 切分為訓練集與測試集,並視覺化它們的分布以找出可能的差異。
注意:seaborn 與 matplotlib.pyplot 已為你匯入,並分別以 sns 與 plt 作為別名。
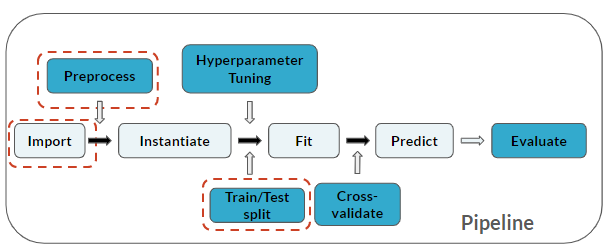
現在的管線已包含 Train/Test split:
本練習屬於課程
用 Python 練習機器學習面試題
練習說明
- 將
loan_data子集化為僅包含Credit Score、Annual Income特徵,以及目標變數Loan Status,且順序即為上述排列。 - 對
loan_data建立 80/20 的切分,並指定為loan_data_subset。 - 分別為
trainingSet與testSet(依此順序)建立 pairplot,並將hue參數設為目標變數Loan Status。
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Create `loan_data` subset: loan_data_subset
loan_data_subset = ____[['____','____','____']]

# Create train and test sets
trainingSet, testSet = ____(____, ____=___, random_state=123)

# Examine pairplots
plt.figure()
sns.____(____, hue='____', palette='RdBu')
plt.show()

plt.figure()
sns.____(____, hue='____', palette='RdBu')
plt.show()