反覆插補(Iterative imputation)
在前一個練習中,你為 loan_data 的遺漏值計算了平均數插補。不過,在機器學習面試中,常會被問到更動態的插補技巧,這些方法會利用資料集中的其他特徵來推估。
在本練習中,你將練習一種基於機器學習的方法:使用 sklearn.impute 的 IterativeImputer(),把遺漏值視為其他特徵的函式來進行插補。這是一種多變量插補器,會以「輪流(round-robin)」的方式,使用其餘所有特徵來估計每一個特徵。
請注意,此函式仍屬於實驗性功能。想了解更多,請參考其文件。
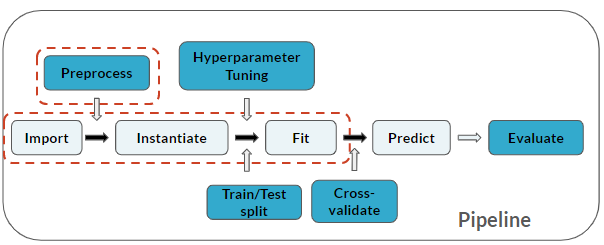
你目前位於同一個 Pipeline 的步驟:
本練習屬於課程
用 Python 練習機器學習面試題
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Explicitly require this experimental feature
from sklearn.experimental import enable_iterative_imputer
# Now you can import normally from sklearn.impute
from sklearn.impute import IterativeImputer

# Subset numeric features: numeric_cols
numeric_cols = ____.____(____=[____.____])