Silhouette 方法
在上一個課程中,你已經體會到叢集數量不同會如何影響 K-Means 演算法的效能。這在面試情境中特別重要,因為找出最佳的叢集數能帶來最好的結果。
在這個練習中,你會對在 diabetes DataFrame 上執行的 K-Means 演算法使用 sklearn.metrics 的 silhouette_score() 函式,來實作 Silhouette 方法以尋找最佳的叢集數。請注意,計算分數時會使用歐幾里得距離(euclidian distance),以確保它和 Elbow 方法之間具有可比性。
訓練 K-Means 模型所需的特徵矩陣 X 已經為你建立好。
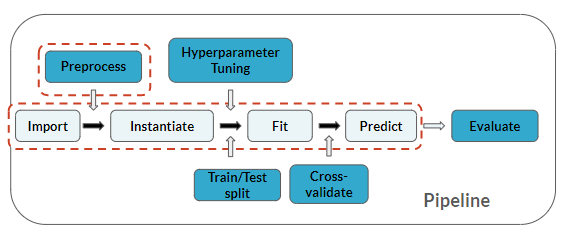
你目前在流程中的位置與前幾個練習相同,不過這裡你還會加入「預測」這一步:
本練習屬於課程
用 Python 練習機器學習面試題
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Import modules
from sklearn.____ import ____
from sklearn.____ import ____