對數與冪次轉換
在上一個練習中,你比較了 loan_data 的訓練集與測試集之分佈。這在機器學習面試中特別重要,因為觀察到的分佈會決定你是否需要使用一些技巧,把特徵的分佈推向常態分佈,以免違反常態性假設。
在本練習中,你會使用 scipy.stats 模組中的對數與冪次轉換,套用到 loan_data 的 Years of Credit History 特徵,並搭配 seaborn 的 distplot() 函式,同時繪出其分佈與核密度估計。
所有相關套件都已為你匯入。
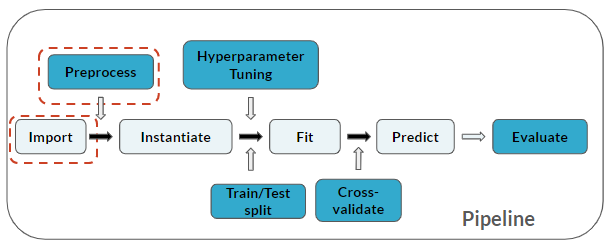
你目前在這個流程中的位置如下:
本練習屬於課程
用 Python 練習機器學習面試題
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Subset loan_data
cr_yrs = ____['____']

# Histogram and kernel density estimate
plt.figure()
sns.____(____)
plt.show()