Logistic Regression 基準分類器
在前兩個課程中,你學到特徵選擇在機器學習面試情境中的重要性。另一組常見的面試題與特徵工程有關,以及它如何幫助提升模型效能。
在這個練習中,你將在第 1 章的 loan_data 資料集上建構一個新特徵,並比較進行特徵工程前後,使用邏輯斯迴歸(Logistic Regression)在該資料集上的準確率分數。方法是將測試集標籤與目標變數 Loan Status 的預測值進行比對。
所有相關套件都已為你匯入:matplotlib.pyplot 作為 plt、seaborn 作為 sns、從 sklearn.linear_model 匯入 LogisticRegression、從 sklearn.model_selection 匯入 train_test_split,以及從 sklearn.metrics 匯入 accuracy_score。
特徵工程被視為建模前的前處理步驟:
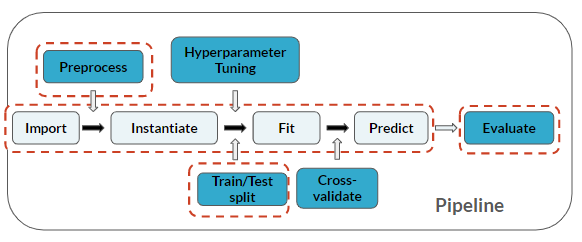
本練習屬於課程
用 Python 練習機器學習面試題
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Create X matrix and y array
X = loan_data.____("____", axis=1)
y = loan_data["____"]

# Train/test split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=123)

# Instantiate
logistic = ____()

# Fit
logistic.____(____, ____)

# Predict and print accuracy
print(____(y_true=____, y_pred=logistic.____(____)))