K-means 分群
在機器學習面試中,面試官可能會問你如何使用 K-means 分群的輸出來評估其表現,判斷它是否是最佳的演算法。
在這個練習中,你將實作 K-means 分群。你會使用 .inertia_ 屬性來比較在不同群數 k 下的模型。接著,你也會在下一個練習中利用這些資訊來評估合適的群數。
回想一下,diabetes 資料集中的目標變數是 progression。
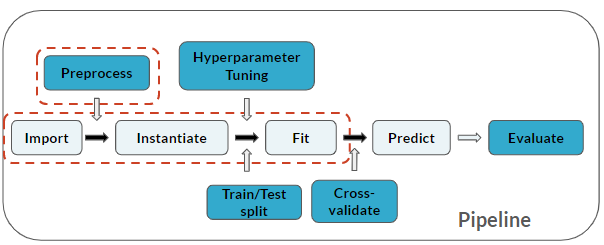
你在工作流程中的位置:
本練習屬於課程
用 Python 練習機器學習面試題
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Import module
from sklearn.cluster import KMeans

# Create feature matrix
X = diabetes.____("____", axis=1)

# Instantiate
kmeans = KMeans(n_clusters=2, random_state=123)

# Fit
fit = kmeans.____(____)

# Print inertia
print("Sum of squared distances for 2 clusters is", kmeans.inertia_)