Fine-tuning CV: เตรียมชุดข้อมูล
ในแบบฝึกหัดนี้ จะเตรียม Stanford Cars dataset สำหรับการฝึกโมเดล โดยใช้ไลบรารี datasets เพื่อแบ่งชุดข้อมูล และนำ transformation สำหรับการประมวลผลล่วงหน้าไปใช้ ชุดข้อมูลประกอบด้วยภาพรถยนต์ที่มีป้ายกำกับ 8,000 ภาพ ครอบคลุมรถยนต์ 196 รุ่น:
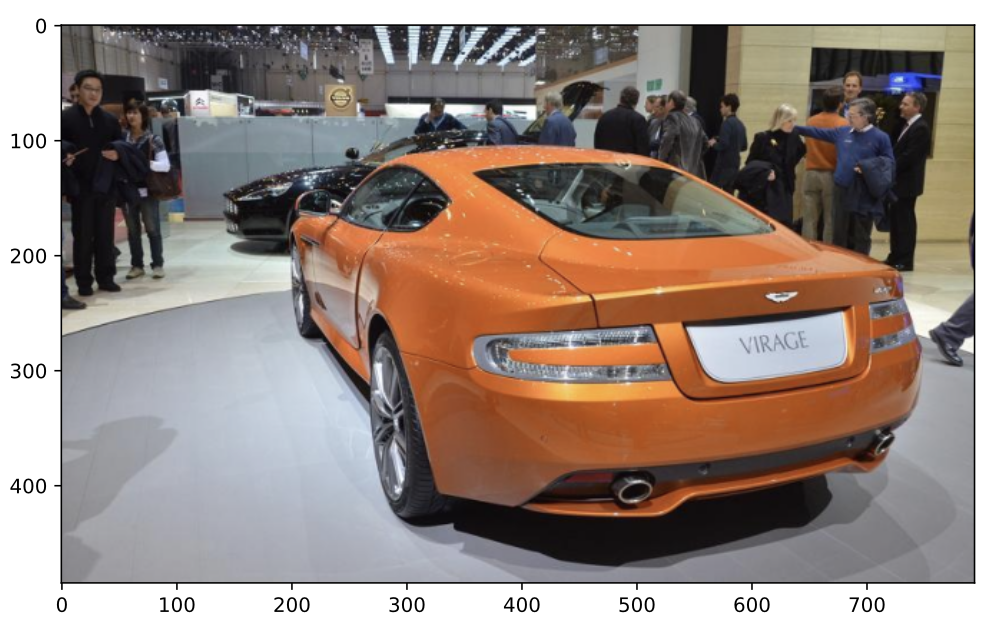
ชุดข้อมูลถูกโหลดไว้แล้วในตัวแปร dataset และมีการกำหนด transformation ไว้ให้แล้วในชื่อ transforms ซึ่งประกอบด้วยการ renormalization และการแปลงชนิดข้อมูล
แบบฝึกหัดนี้เป็นส่วนหนึ่งของหลักสูตร
โมเดล Multi-Modal ด้วย Hugging Face
คำแนะนำการฝึกหัด
- แบ่งข้อมูลใน
datasetเป็นชุด train/test ในสัดส่วน 80/20 โดยใช้เมธอด.train_test_split() - นำ transformation (
transforms) ไปใช้กับdata_splits - พล็อตภาพที่ผ่านการ augment จากชุดค่า pixel แรกใน
dataset_transformed
แบบฝึกหัดเชิงโต้ตอบแบบลงมือทำ
ลองทำแบบฝึกหัดนี้โดยเติมโค้ดตัวอย่างนี้ให้สมบูรณ์
# Create a train/test split within the HF dataset
data_splits = ____(test_size=____, seed=42)

# Apply the transformations
dataset_transformed = ____

# Plot the transformed image
plt.imshow(dataset_transformed["train"][0]["____"].permute(1, 2, 0))
plt.show()