การกำจัดเสียงรบกวน
ในแบบฝึกหัดนี้ คุณจะใช้ข้อมูลจากชุดข้อมูล WHAM ซึ่งผสมเสียงพูดเข้ากับเสียงรบกวนพื้นหลัง เพื่อสร้างเสียงพูดใหม่ในเสียงที่แตกต่างออกไปโดยไม่มีเสียงรบกวน!
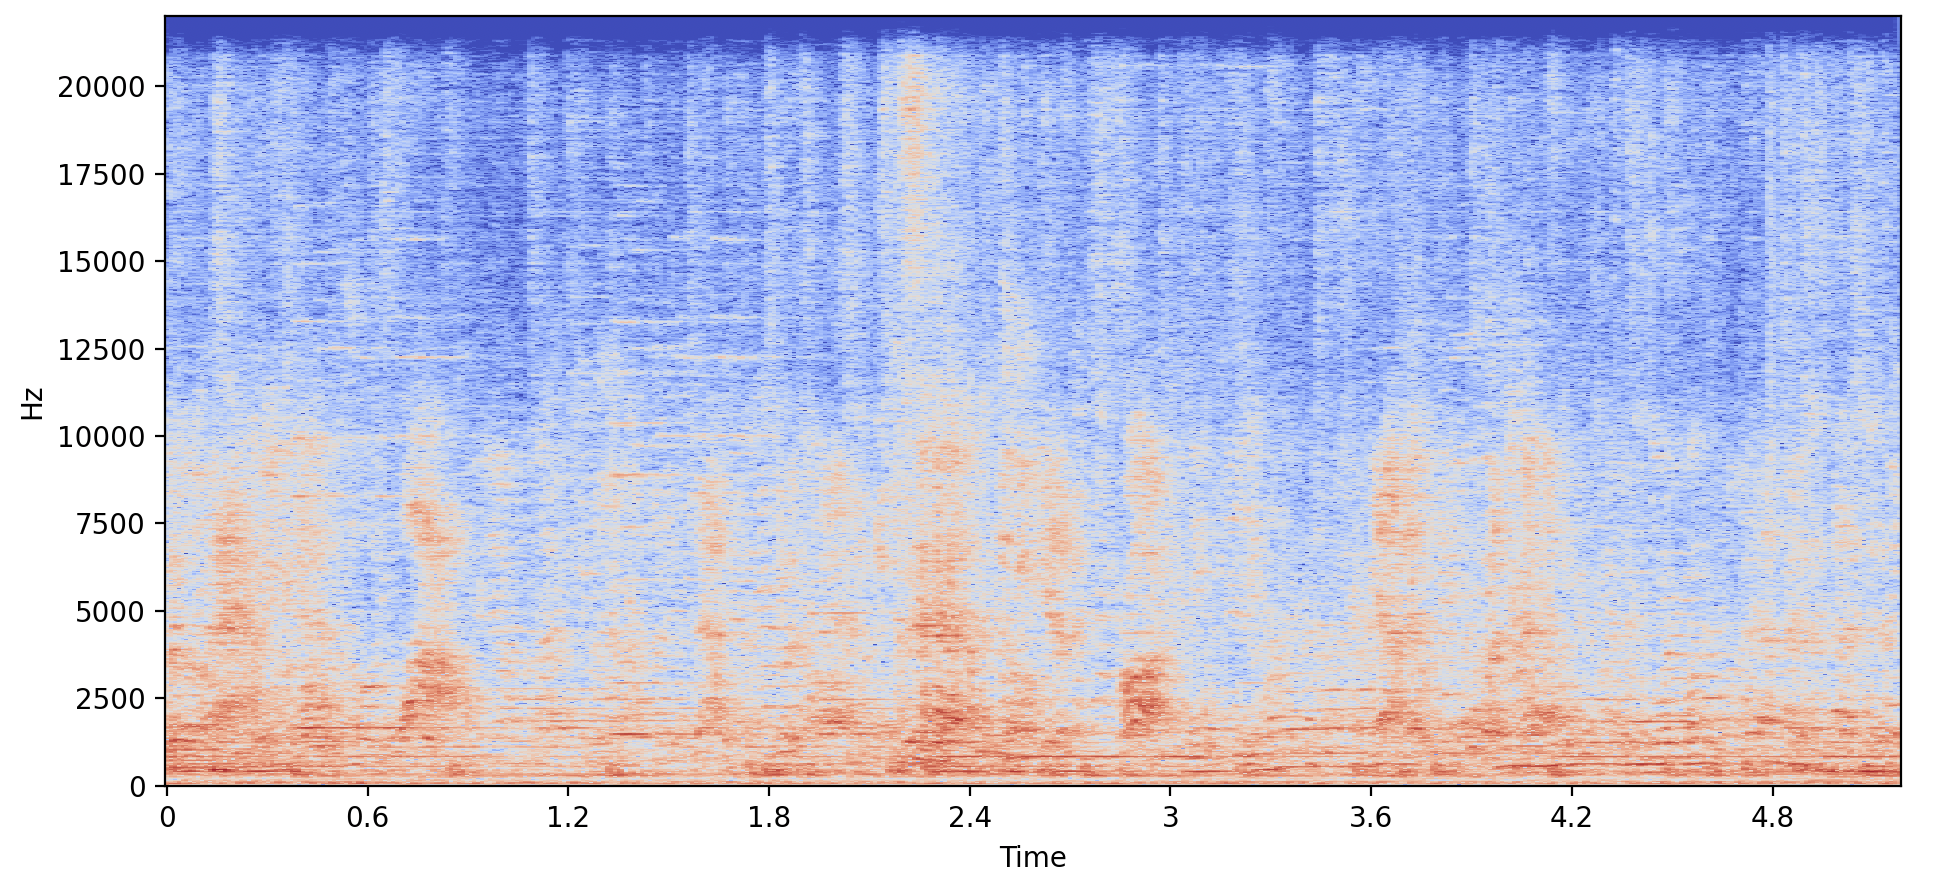
อาร์เรย์ example_speech และเวกเตอร์ speaker_embedding ของเสียงใหม่ถูกโหลดไว้แล้ว รวมถึง preprocessor (processor), vocoder (vocoder) และโมดูล SpeechT5ForSpeechToSpeech นอกจากนี้ยังมีฟังก์ชัน make_spectrogram() สำหรับช่วยในการพล็อตกราฟ
แบบฝึกหัดนี้เป็นส่วนหนึ่งของหลักสูตร
โมเดล Multi-Modal ด้วย Hugging Face
คำแนะนำการฝึกหัด
- โหลดโมเดล pretrained
SpeechT5ForSpeechToSpeechโดยใช้ checkpointmicrosoft/speecht5_vc - ประมวลผล
example_speechล่วงหน้าด้วย sampling rate16000 - สร้างเสียงพูดที่กำจัดเสียงรบกวนแล้วโดยใช้
.generate_speech()
แบบฝึกหัดเชิงโต้ตอบแบบลงมือทำ
ลองทำแบบฝึกหัดนี้โดยเติมโค้ดตัวอย่างนี้ให้สมบูรณ์
# Load the SpeechT5ForSpeechToSpeech pretrained model
model = ____

# Preprocess the example speech
inputs = ____(audio=____, sampling_rate=____, return_tensors="pt")

# Generate the denoised speech
speech = ____

make_spectrogram(speech)
sf.write("speech.wav", speech.numpy(), samplerate=16000)