การประมวลผลภาพเบื้องต้น
ในแบบฝึกหัดนี้ คุณจะใช้ชุดข้อมูล flickr ซึ่งประกอบด้วยภาพ 30,000 รูปพร้อมคำบรรยาย เพื่อทำการประมวลผลภาพเบื้องต้น ขั้นตอนนี้จำเป็นสำหรับการเตรียมข้อมูลภาพให้พร้อมสำหรับการอนุมานด้วยโมเดล Hugging Face เช่น การสร้างข้อความจากภาพ โดยในที่นี้จะสร้างคำบรรยายสำหรับภาพนี้:
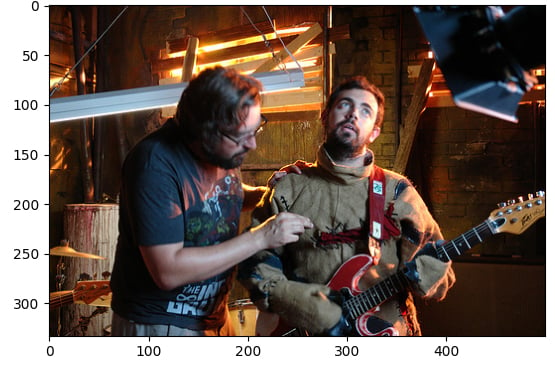
ชุดข้อมูล (dataset) ถูกโหลดด้วยโครงสร้างดังนี้:
Dataset({
    features: ['image', 'caption', 'sentids', 'split', 'img_id', 'filename'],
    num_rows: 10
})
โมเดลสำหรับสร้างคำบรรยายภาพ (model) ถูกโหลดเรียบร้อยแล้ว
แบบฝึกหัดนี้เป็นส่วนหนึ่งของหลักสูตร
โมเดล Multi-Modal ด้วย Hugging Face
คำแนะนำการฝึกหัด
- โหลดภาพจากองค์ประกอบที่ index
5ของชุดข้อมูล - โหลด image processor (
BlipProcessor) ของโมเดล pretrained:Salesforce/blip-image-captioning-base - รัน processor บน
imageโดยระบุว่าต้องการ tensor แบบ PyTorch (pt) - ใช้เมธอด
.generate()เพื่อสร้างคำบรรยายด้วยmodel
แบบฝึกหัดเชิงโต้ตอบแบบลงมือทำ
ลองทำแบบฝึกหัดนี้โดยเติมโค้ดตัวอย่างนี้ให้สมบูรณ์
# Load the image from index 5 of the dataset
image = dataset[5]["____"]

# Load the image processor of the pretrained model
processor = ____.____("Salesforce/blip-image-captioning-base")

# Preprocess the image
inputs = ____(images=____, return_tensors="pt")

# Generate a caption using the model
output = ____(**inputs)
print(f'Generated caption: {processor.decode(output[0])}')
print(f'Original caption: {dataset[5]["caption"][0]}')