混淆矩陣
使用 scikit-learn 的 confusion_matrix() 函式,你可以輕鬆建立分類器的混淆矩陣,並更細緻地了解其效能。它需要兩個引數:測試集的實際標籤 y_test,以及你的預測標籤。
上一題中隨機森林分類器的預測標籤已存於 y_pred,其計算方式如下:
y_pred = clf.predict(X_test)
重要說明:sklearn 在預設情況下是以下列方式計算混淆矩陣:
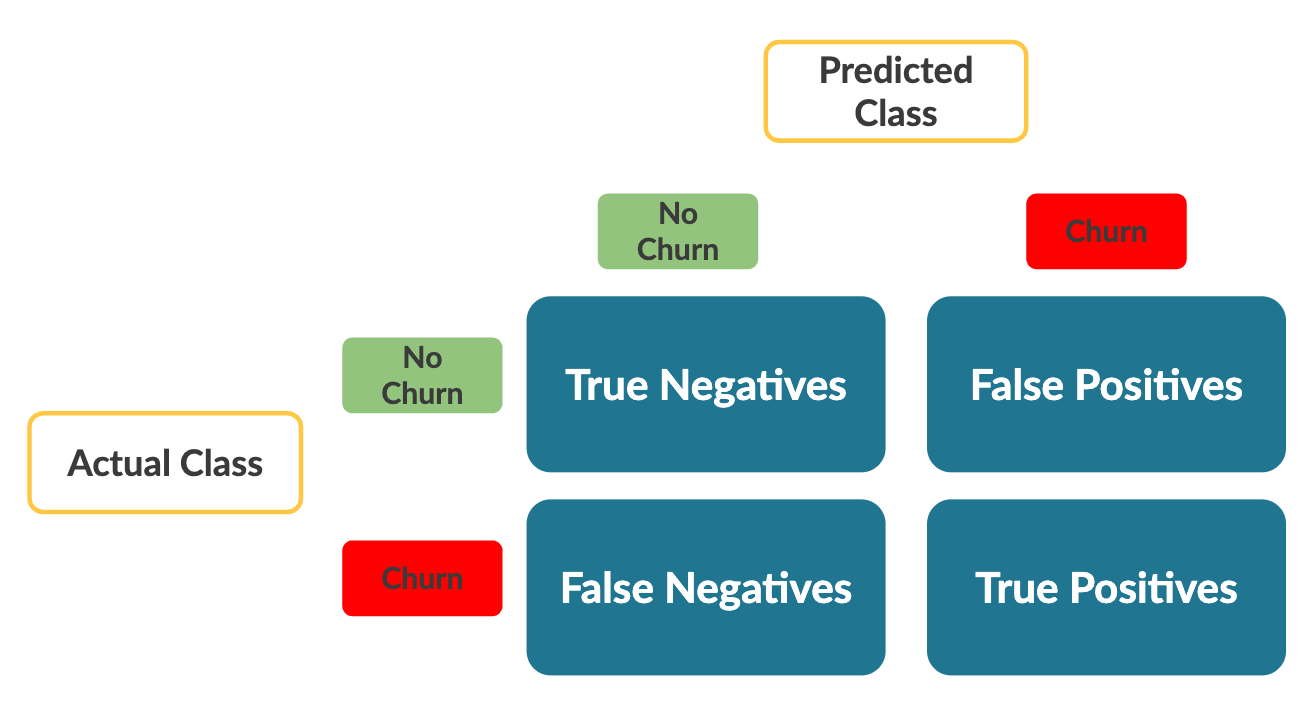
請注意,座標軸與你在影片中看到的是相反的。指標本身不變,但在解讀表格時要記得這點。
本練習屬於課程