Puterea corelației
Intuitiv, putem privi graficele furnizate și „vedea" dacă cele două variabile par să „varieze împreună".
- Setul de date A: x și y se modifică împreună și par să aibă o relație puternică.
- Setul de date B: există o tendință aproximativă ascendentă; x și y par doar vag legate.
- Setul de date C: arată ca o dispersie aleatoare; x și y nu par să se modifice împreună și sunt necorelate.
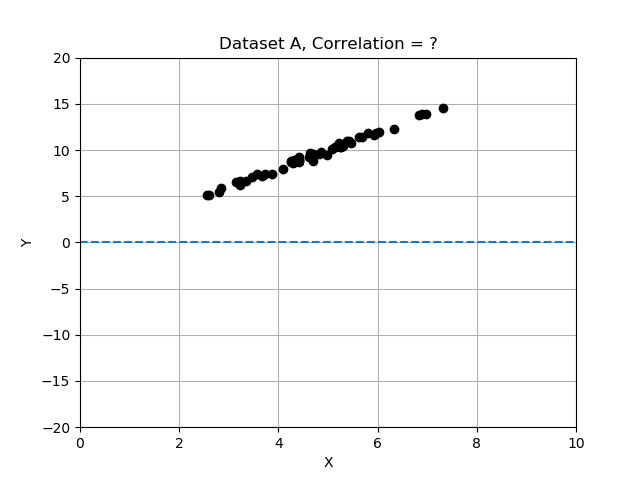
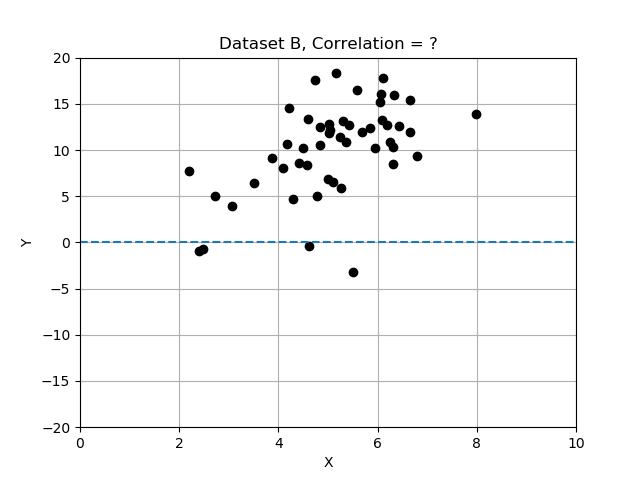
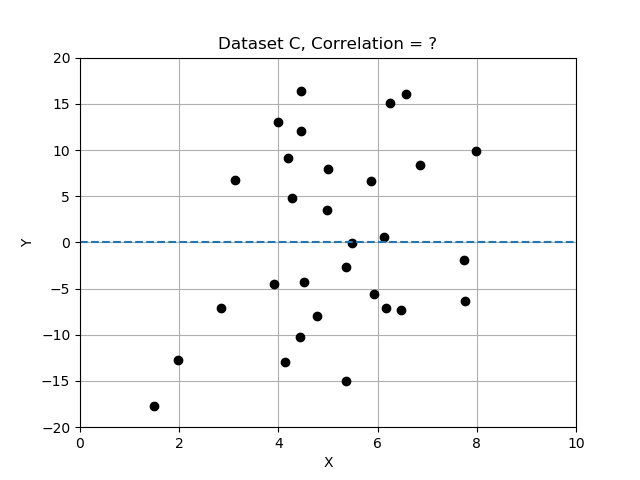
Amintește-ți că abaterile sunt calculate față de medie și că le-am normalizat împărțindu-le la abaterea standard. În acest exercițiu vei compara cele 3 seturi de date calculând corelația și determinând care set de date are variabilele x și y cel mai puternic corelate. Folosește tabelul de date furnizat data_sets, un dicționar de înregistrări, fiecare având cheile 'name', 'x', 'y' și 'correlation'.
Acest exercițiu face parte din cursul
Introducere în modelarea liniară în Python
Instrucțiuni pentru exercițiu
- Completează definiția funcției
correlation()folosind media produselor abaterilor normalizate ale luixșiy. - Iterează peste
data_sets, calculând și stocând fiecare corelație folosindcorrelation(record['x'], record['y']). - Rulează codul până în acest punct (adică până la sfârșitul buclei
for) și inspectează rezultatele afișate. Care set de date are cea mai puternică corelație? - Atribuie variabilei
best_datanumele setului de date (data_sets['A'],data_sets['B']saudata_sets['C']) cu cea mai puternică corelație.
Exercițiu interactiv practic
Încearcă acest exercițiu completând acest cod de exemplu.
# Complete the function that will compute correlation.
def correlation(x,y):
    x_dev = x - np.____(x)
    y_dev = y - np.____(y)
    x_norm = x_dev / np.____(x)
    y_norm = y_dev / np.____(y)
    return np.____(x_norm * y_norm)

# Compute and store the correlation for each data set in the list.
for name, data in data_sets.items():
    data['correlation'] = ____(data['x'], data['y'])
    print('data set {} has correlation {:.2f}'.format(name, data['correlation']))

# Assign the data set with the best correlation.
best_data = data_sets['____']