Maximizarea verosimilității, Partea 1
Anterior, am ales media eșantionului ca estimare a parametrului mu al modelului populației. Dar cum știm că media eșantionului este cel mai bun estimator? Această întrebare este mai delicată, așa că o vom aborda în două părți.
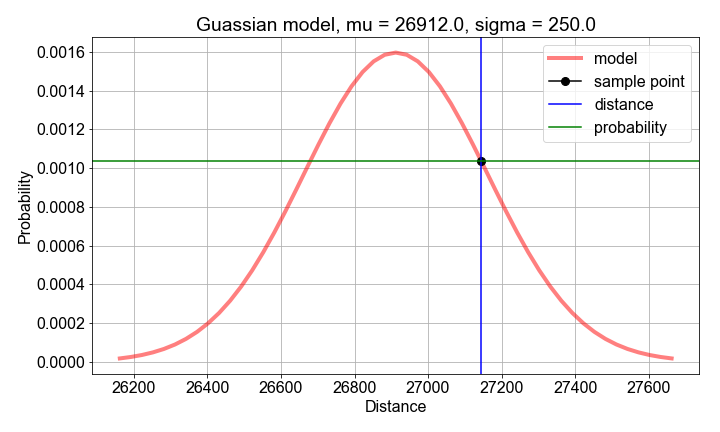
În Partea 1, vei folosi o abordare computațională pentru a calcula log-verosimilitatea unui estimator dat. Apoi, în Partea 2, vom vedea că atunci când calculezi log-verosimilitatea pentru multe valori posibile ale estimatorului, una dintre ele va produce verosimilitatea maximă.
Acest exercițiu face parte din cursul
Introducere în modelarea liniară în Python
Instrucțiuni pentru exercițiu
- Calculează
mean()șistd()ale variabilei preîncărcatesample_distancesca valori estimate ale parametrilor modelului probabilistic. - Calculează probabilitatea pentru fiecare valoare
distance, folosindgaussian_model()construit dinsample_meanșisample_stdev. - Calculează
loglikelihoodcasum()allog()-ului probabilitățilorprobs.
Exercițiu interactiv practic
Încearcă acest exercițiu completând acest cod de exemplu.
# Compute sample mean and stdev, for use as model parameter value guesses
mu_guess = np.____(sample_distances)
sigma_guess = np.____(sample_distances)

# For each sample distance, compute the probability modeled by the parameter guesses
probs = np.zeros(len(sample_distances))
for n, distance in enumerate(sample_distances):
    probs[n] = gaussian_model(____, mu=____, sigma=____)

# Compute and print the log-likelihood as the sum() of the log() of the probabilities
loglikelihood = np.____(np.____(probs))
print('For guesses mu={:0.2f} and sigma={:0.2f}, the loglikelihood={:0.2f}'.format(mu_guess, sigma_guess, ____))