不只文字:斷詞(2)
tidytext 套件能讓你用「tidyverse」的套件(例如 dplyr 和 sparklyr)來分析文字資料。情感分析本課不會深入,你可以參考課程[Sentiment Analysis](https://www.datacamp.com/courses/sentiment-analysis-in-r)。這個練習會讓你快速體驗如何在 Spark 上進行情感分析。
情感分析的核心,是為每個單字指派一個分數或情緒。例如在 AFINN 詞庫中,"outstanding" 的分數是 +5,因為幾乎總是在正向語境中使用。"grace" 是略為正向的字,分數是 +1。"fraud" 通常出現在負向語境中,分數是 -4。AFINN 分數的資料集可由 get_sentiments("afinn") 取得。為了方便,未嵌套的單字資料與情感詞彙表已經複製到 Spark。
通常你會想比較多個資料群組的情感分數。可以使用下列程式碼樣式:
text_data %>%
  inner_join(sentiments, by = "word") %>%
  group_by(some_group) %>%
  summarize(positivity = sum(score))
Inner join 會從第一個資料表取出所有值,並在第二個資料表中尋找相符的記錄。若找到相符值,就把第二個表的資料加進來。與 left join 不同的是,找不到相符值的列會被丟棄。原理如下圖所示。
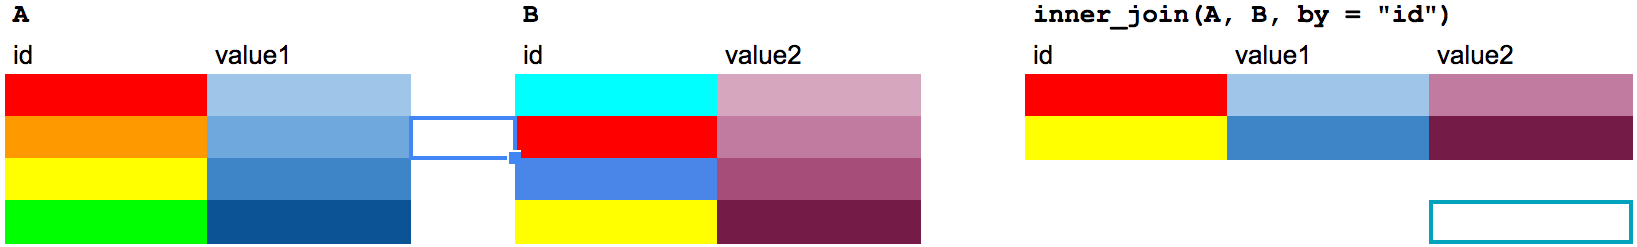
和 left join 一樣,inner join 也屬於會新增欄位的「mutating join」。試著猜猜應該用哪個函式來做 inner join,以及如何使用它。(提示:用法和 left_join()、anti_join()、semi_join() 非常相似!)
本練習屬於課程
使用 R 的 sparklyr:Spark 入門
練習說明
我們已為你建立 spark_conn 的 Spark 連線。已預先在 Spark 中定義了包含歌名文字與情感詞彙表的 tibbles,分別為 title_text_tbl 與 afinn_sentiments_tbl。
- 從
title_text_tbl建立名為sentimental_artists的變數。- 使用
inner_join(),以"word"為鍵,將afinn_sentiments_tbl與title_text_tbl合併。 - 依
artist_name分組。 - 彙總並定義變數
positivity,其值為score欄位的總和。
- 使用
- 找出歌曲標題最負面的前 5 位歌手。
- 依
positivity遞增排序sentimental_artists。 - 使用
slice_max取得前 5 筆結果。
- 依
- 找出歌曲標題最正面的前 5 位歌手。
- 依
positivity遞減排序sentimental_artists。 - 取得前 5 筆結果。
- 依
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# title_text_tbl, afinn_sentiments_tbl have been pre-defined
title_text_tbl
afinn_sentiments_tbl

sentimental_artists <- title_text_tbl %>%
  # Inner join with sentiments on word field
  ___ %>%
  # Group by artist
  ___ %>%
  # Summarize to get positivity
  ___

sentimental_artists %>%
  # Arrange by ascending positivity
  ___ %>%
  # Get top 5
  ___

sentimental_artists %>%
  # Arrange by descending positivity
  ___ %>%
  # Get top 5
  ___