讓你的資料也帶點 Spark
在上一個練習中,你已經看到如何把資料從 Spark 移到 pandas。不過,有時你會想反過來,將一個 pandas 的 DataFrame 放進 Spark 叢集!SparkSession 類別也提供了對應的方法。
.createDataFrame() 方法會接收一個 pandas 的 DataFrame,並回傳一個 Spark 的 DataFrame。
此方法的輸出會儲存在本機端,而不是 SparkSession 的目錄(catalog)中。這代表你可以使用所有 Spark DataFrame 的方法操作它,但無法在其他情境中直接存取這份資料。
例如,若你用 .sql() 方法執行一段 SQL 查詢並引用你的 DataFrame,會拋出錯誤。若要用這種方式存取資料,你必須先把它儲存為「暫存資料表(temporary table)」。
你可以使用 Spark DataFrame 的 .createTempView() 方法來做到這點。它唯一的引數是你想註冊的暫存資料表名稱。這個方法會將該 DataFrame 註冊為目錄中的資料表;但由於是暫存表,只能從用來建立該 Spark DataFrame 的那個 SparkSession 存取。
此外還有 .createOrReplaceTempView() 方法。如果原本沒有同名表,它會安全地建立新的暫存表;如果已經有同名表,則會更新既有的表。你將使用這個方法來避免重複資料表所造成的問題。
看看下圖,了解 Spark 各種資料結構之間如何互相運作。
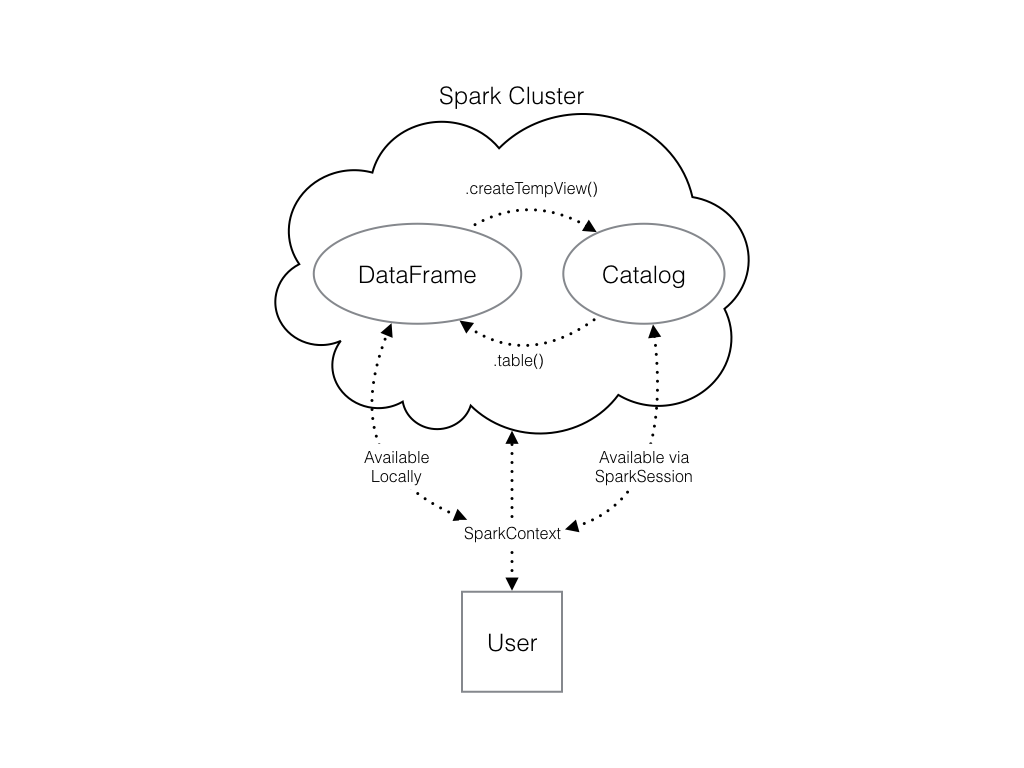
你的工作區中已經有名為 spark 的 SparkSession,且已匯入 numpy 為 np、pandas 為 pd。
本練習屬於課程
PySpark 基礎
練習說明
- 建立隨機數的
pandasDataFrame 的程式碼已提供並儲存在pd_temp。 - 呼叫 Spark 的
.createDataFrame()方法,並以pd_temp作為引數,建立名為spark_temp的 Spark DataFrame。 - 檢視你 Spark 叢集中的資料表清單並確認新的 DataFrame「不」在其中。記得你可以使用
spark.catalog.listTables()。 - 使用
.createOrReplaceTempView()方法,將你剛建立的spark_tempDataFrame 註冊為暫存資料表。暫存資料表名稱應為"temp"。記得資料表名稱要作為該方法的唯一引數! - 再次檢視資料表清單。
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Create pd_temp
pd_temp = pd.DataFrame(np.random.random(10))

# Create spark_temp from pd_temp
spark_temp = ____

# Examine the tables in the catalog
print(____)

# Add spark_temp to the catalog
spark_temp.____

# Examine the tables in the catalog again
print(____)