Skapa slumpmässiga testdatamängder
Innan du bygger en mer avancerad kreditmodell är det viktigt att avsätta en del av lånedata för att simulera hur väl modellen kommer att förutsäga utfallen för framtida lånesökande.
Som bilden nedan visar kan du använda 75 % av observationerna för träning och 25 % för att testa modellen.
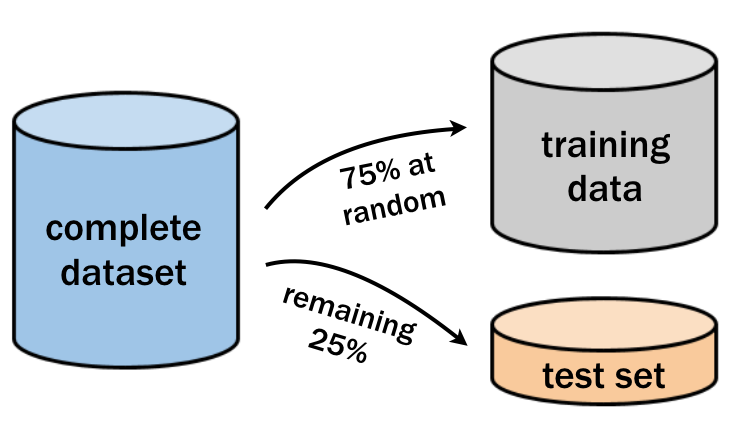
Funktionen sample() kan användas för att generera ett slumpmässigt urval av rader att inkludera i träningsdatan. Ange bara det totala antalet observationer och hur många som behövs för träning.
Använd den resulterande vektorn med rad-ID:n för att dela upp loans i en tränings- och en testdatamängd. Datamängden loans finns tillgänglig för dig att använda.
Den här övningen är en del av kursen
Övervakat lärande i R: Klassificering
Övningsinstruktioner
- Använd funktionen
nrow()för att ta reda på hur många observationer datamängdenloansinnehåller, samt hur många som behövs för ett urval på 75 %. - Använd funktionen
sample()för att skapa en heltalsvektor med rad-ID:n för urvalet på 75 %. Det första argumentet tillsample()ska vara antalet rader i datamängden och det andra är antalet rader du behöver i din träningsuppsättning. - Filtrera
loans-datan med hjälp av rad-ID:na för att skapa träningsdatamängden. Spara den somloans_train. - Filtrera
loansigen, men välj den här gången alla rader som inte finns isample_rows. Spara detta somloans_test.
Interaktiv övning med praktiskt arbete
Testa den här övningen genom att slutföra den här exempelkoden.
# Determine the number of rows for training


# Create a random sample of row IDs
sample_rows <- sample(___, ___)

# Create the training dataset
loans_train <- loans[___]

# Create the test dataset
loans_test <- loans[___]