Sentiment i scootersamhället
Stadsfullmäktige är nyfikna på hur olika grupper i staden reagerar på scootrarna. Datamängden har utökats sedan Sams första analys och innehåller nu rapporter på vietnamesiska, tagalog, spanska och engelska.
De ber Sam undersöka om hon kan ta reda på det. Hon bestämmer sig för att använda språk som ett mått på vilken grupp ett svar kommer från – åtminstone utifrån den data hon har tillgång till just nu.
Hon har redan läst in CSV-filen i variabeln scooter_df:
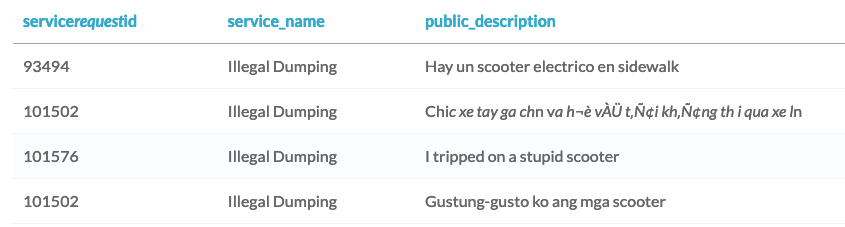
I den här övningen hjälper du Sam att analysera sentiment på flera olika språk. Det ger staden en bättre förståelse för hur olika grupper förhåller sig till scootrarna – något som kan påverka hur ledamöterna i stadsfullmäktige röstar.
Den här övningen är en del av kursen
Introduktion till AWS Boto i Python
Övningsinstruktioner
- Identifiera det dominerande språket för varje rad i DataFrame:n.
- Använd det identifierade språket för att fastställa sentimentet i beskrivningen.
- Gruppera DataFrame:n efter kolumnerna
'sentiment'och'lang', i den ordningen.
Interaktiv övning med praktiskt arbete
Testa den här övningen genom att slutföra den här exempelkoden.
for index, row in scooter_requests.iterrows():
  	# For every DataFrame row
    desc = scooter_requests.loc[index, 'public_description']
    if desc != '':
      	# Detect the dominant language
        resp = comprehend.____(____=desc)
        lang_code = resp['Languages'][0]['LanguageCode']
        scooter_requests.loc[index, 'lang'] = lang_code
        # Use the detected language to determine sentiment
        scooter_requests.loc[index, 'sentiment'] = comprehend.____(
          ____=desc,
          ____=lang_code)['____']
# Perform a count of sentiment by group.
counts = scooter_requests.groupby(['sentiment', 'lang']).count()
counts.head()