Zaciśnięta zastępcza funkcja celu
Zaimplementuj funkcję calculate_loss() dla PPO. Wymaga to zakodowania kluczowej innowacji PPO – zaciśniętej zastępczej funkcji straty. Ogranicza ona aktualizację polityki, dzięki czemu przy każdym kroku nie oddala się zbytnio od poprzedniej polityki.
Wzór na zaciśniętą zastępczą funkcję celu to
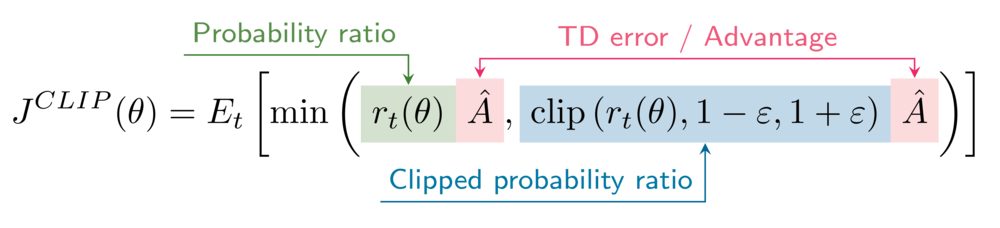
W twoim środowisku hiperparametr zaciśnięcia epsilon jest ustawiony na 0,2.
To ćwiczenie jest częścią kursu
Głębokie uczenie ze wzmocnieniem w Pythonie
Instrukcje do ćwiczenia
- Oblicz współczynniki prawdopodobieństwa między
\pi_\thetaa\pi_{\theta_{old}}(wersję niezaciśniętą i zaciśniętą). - Oblicz zastępcze funkcje celu (wersję niezaciśniętą i zaciśniętą).
- Oblicz zaciśniętą zastępczą funkcję celu PPO.
- Oblicz stratę aktora.
Interaktywne ćwiczenie praktyczne
Spróbuj tego ćwiczenia, uzupełniając ten przykładowy kod.
def calculate_losses(critic_network, action_log_prob, action_log_prob_old,
                     reward, state, next_state, done):
    value = critic_network(state)
    next_value = critic_network(next_state)
    td_target = (reward + gamma * next_value * (1-done))
    td_error = td_target - value
    # Obtain the probability ratios
    ____, ____ = calculate_ratios(action_log_prob, action_log_prob_old, epsilon=.2)
    # Calculate the surrogate objectives
    surr1 = ratio * ____.____()
    surr2 = clipped_ratio * ____.____()
    # Calculate the clipped surrogate objective
    objective = torch.min(____, ____)
    # Calculate the actor loss
    actor_loss = ____
    critic_loss = td_error ** 2
    return actor_loss, critic_loss

actor_loss, critic_loss = calculate_losses(critic_network, action_log_prob, action_log_prob_old,
                                           reward, state, next_state, done)
print(actor_loss, critic_loss)