Architektura sieci polityki
Zbuduj architekturę sieci polityki (Policy Network), której użyjesz później do trenowania agenta metodą gradientu polityki.
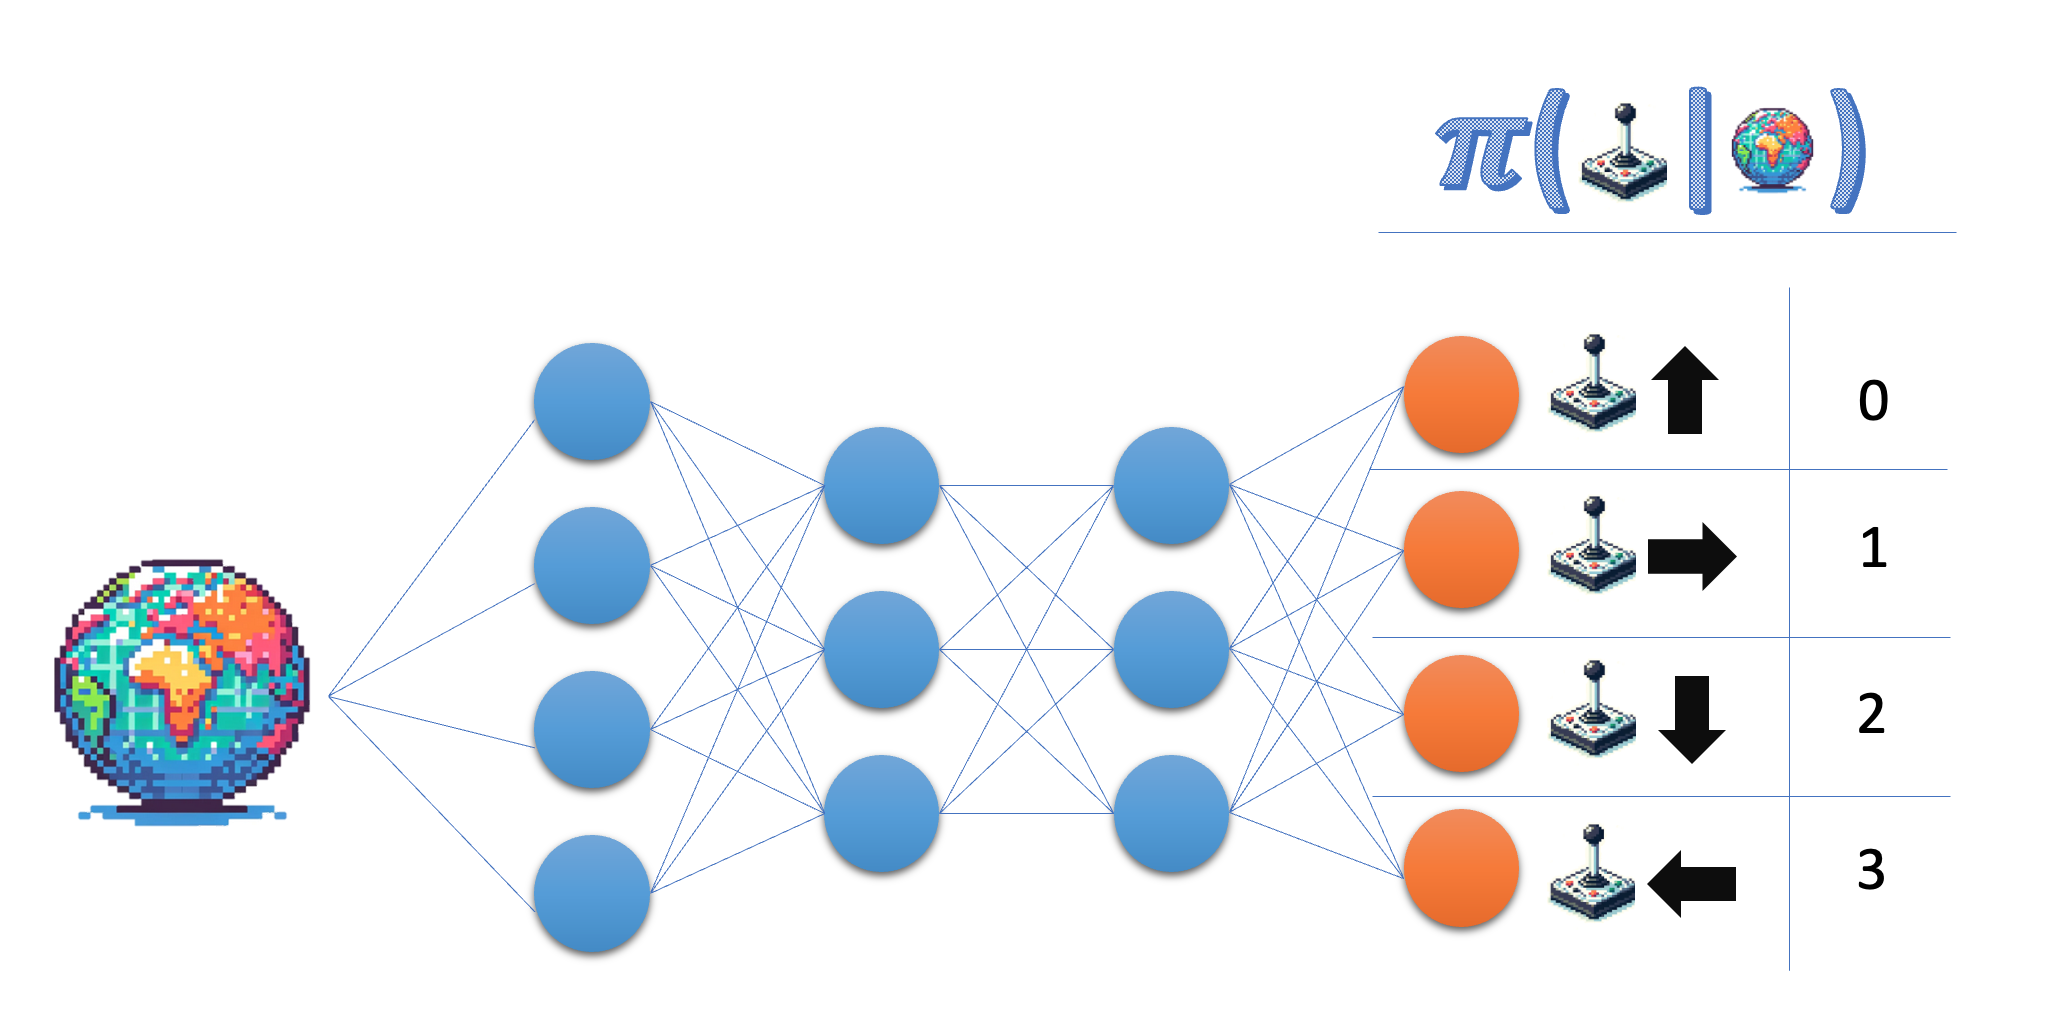
Sieć polityki przyjmuje stan jako dane wejściowe i zwraca rozkład prawdopodobieństwa po przestrzeni akcji. W środowisku Lunar Lander masz do dyspozycji cztery dyskretne akcje, więc sieć powinna zwracać osobne prawdopodobieństwo dla każdej z nich.
To ćwiczenie jest częścią kursu
Głębokie uczenie ze wzmocnieniem w Pythonie
Instrukcje do ćwiczenia
- Określ rozmiar warstwy wyjściowej sieci polityki – dla elastyczności użyj nazwy zmiennej zamiast konkretnej liczby.
- Upewnij się, że ostatnia warstwa zwraca prawdopodobieństwa.
Interaktywne ćwiczenie praktyczne
Spróbuj tego ćwiczenia, uzupełniając ten przykładowy kod.
class PolicyNetwork(nn.Module):
  def __init__(self, state_size, action_size):
    super(PolicyNetwork, self).__init__()
    self.fc1 = nn.Linear(state_size, 64)
    self.fc2 = nn.Linear(64, 64)
    # Give the desired size for the output layer
    self.fc3 = nn.Linear(64, ____)

  def forward(self, state):
    x = torch.relu(self.fc1(torch.tensor(state)))
    x = torch.relu(self.fc2(x))
    # Obtain the action probabilities
    action_probs = ____(self.fc3(x), dim=-1)
    return action_probs

policy_network = PolicyNetwork(8, 4)
action_probs = policy_network(state)
print('Action probabilities:', action_probs)