Funkcja straty w uproszczonym DQN
Funkcja select_action() jest już gotowa – pozostał jeszcze jeden krok, zanim będzie można trenować agenta: teraz zaimplementujesz calculate_loss().
Funkcja calculate_loss() zwraca stratę sieci dla dowolnego kroku epizodu.
Dla przypomnienia, strata jest określona wzorem:
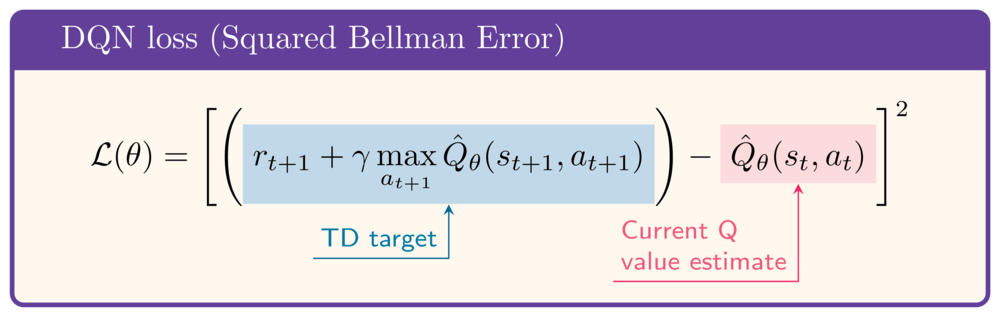
W ćwiczeniu wczytano następujące przykładowe dane:
state = torch.rand(8)
next_state = torch.rand(8)
action = select_action(q_network, state)
reward = 1
gamma = .99
done = False
To ćwiczenie jest częścią kursu
Głębokie uczenie ze wzmocnieniem w Pythonie
Instrukcje do ćwiczenia
- Wyznacz wartość Q dla bieżącego stanu.
- Wyznacz wartość Q dla następnego stanu.
- Oblicz docelową wartość Q, czyli cel TD (TD-target).
- Oblicz funkcję straty, tzn. kwadratowy błąd Bellmana.
Interaktywne ćwiczenie praktyczne
Spróbuj tego ćwiczenia, uzupełniając ten przykładowy kod.
def calculate_loss(q_network, state, action, next_state, reward, done):
    q_values = q_network(state)
    print(f'Q-values: {q_values}')
    # Obtain the current state Q-value
    current_state_q_value = q_values[____]
    print(f'Current state Q-value: {current_state_q_value:.2f}')
    # Obtain the next state Q-value
    next_state_q_value = q_network(next_state).____
    print(f'Next state Q-value: {next_state_q_value:.2f}')
    # Calculate the target Q-value
    target_q_value = ____ + gamma * ____ * (1-done)
    print(f'Target Q-value: {target_q_value:.2f}')
    # Obtain the loss
    loss = nn.MSELoss()(____, ____)
    print(f'Loss: {loss:.2f}')
    return loss

calculate_loss(q_network, state, action, next_state, reward, done)