Trenowanie algorytmu REINFORCE
Czas wytrenować Lunar Lander za pomocą algorytmu REINFORCE! Wystarczy, że zaimplementujesz pętlę treningową REINFORCE, w tym obliczanie straty REINFORCE.
Ponieważ kroki obliczania straty obejmują zarówno pętlę wewnętrzną, jak i zewnętrzną, tym razem nie użyjesz funkcji calculate_loss().
Gdy epizod dobiegnie końca, możesz użyć obu tych wartości do obliczenia straty.
Dla przypomnienia — oto wyrażenie definiujące funkcję straty REINFORCE:
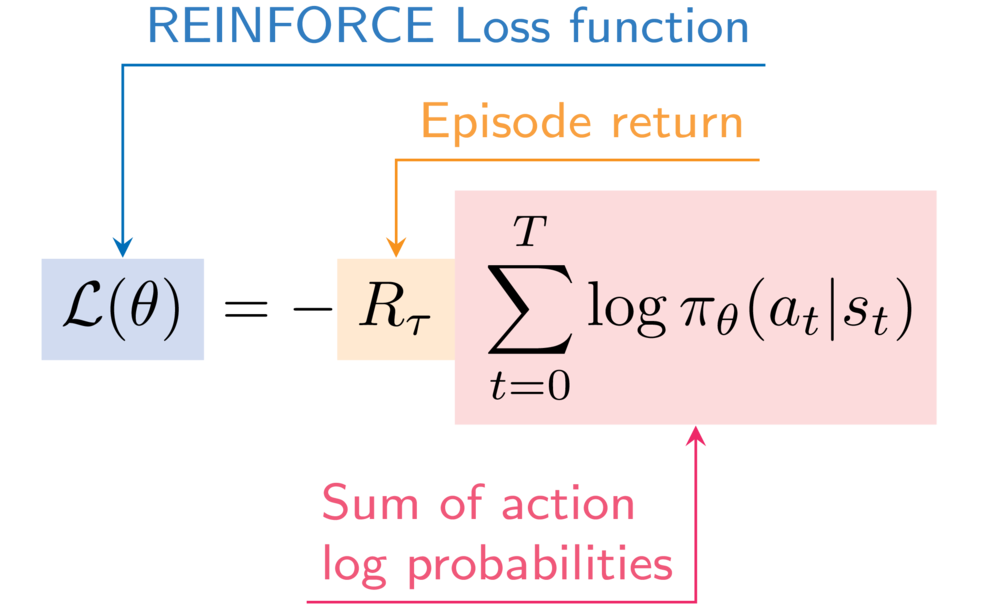
Do wypisywania informacji o postępach agenta w każdym epizodzie ponownie użyjesz funkcji describe_episode().
To ćwiczenie jest częścią kursu
Głębokie uczenie ze wzmocnieniem w Pythonie
Instrukcje do ćwiczenia
- Dodaj logarytm prawdopodobieństwa wybranej akcji do listy logarytmów prawdopodobieństw epizodu.
- Zaktualizuj zwrot epizodu, dodając zdyskontowaną nagrodę bieżącego kroku.
- Oblicz stratę epizodu REINFORCE.
Interaktywne ćwiczenie praktyczne
Spróbuj tego ćwiczenia, uzupełniając ten przykładowy kod.
for episode in range(50):
    state, info = env.reset()
    done = False
    episode_reward = 0
    step = 0
    episode_log_probs = torch.tensor([])
    R = 0
    while not done:
        step += 1
        action, log_prob = select_action(policy_network, state)
        next_state, reward, terminated, truncated, _ = env.step(action)
        done = terminated or truncated
        episode_reward += reward
        # Append to the episode action log probabilities
        episode_log_probs = torch.cat((____, ____))
        # Increment the episode return
        R += (____ ** step) * ____
        state = next_state
    # Calculate the episode loss
    loss = ____ * ____.sum()
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    describe_episode(episode, reward, episode_reward, step)