关系邻居分类器
在本练习中,您将应用一种简单的基于网络的分类器,称为"关系邻居分类器"(relational neighbor classifier)。 它利用相邻节点的类别标签来为网络中的每个节点计算流失概率。 例如,在下图的网络中,红色节点表示流失客户,白色节点表示未流失客户,则蓝色节点的流失概率为 0.4。
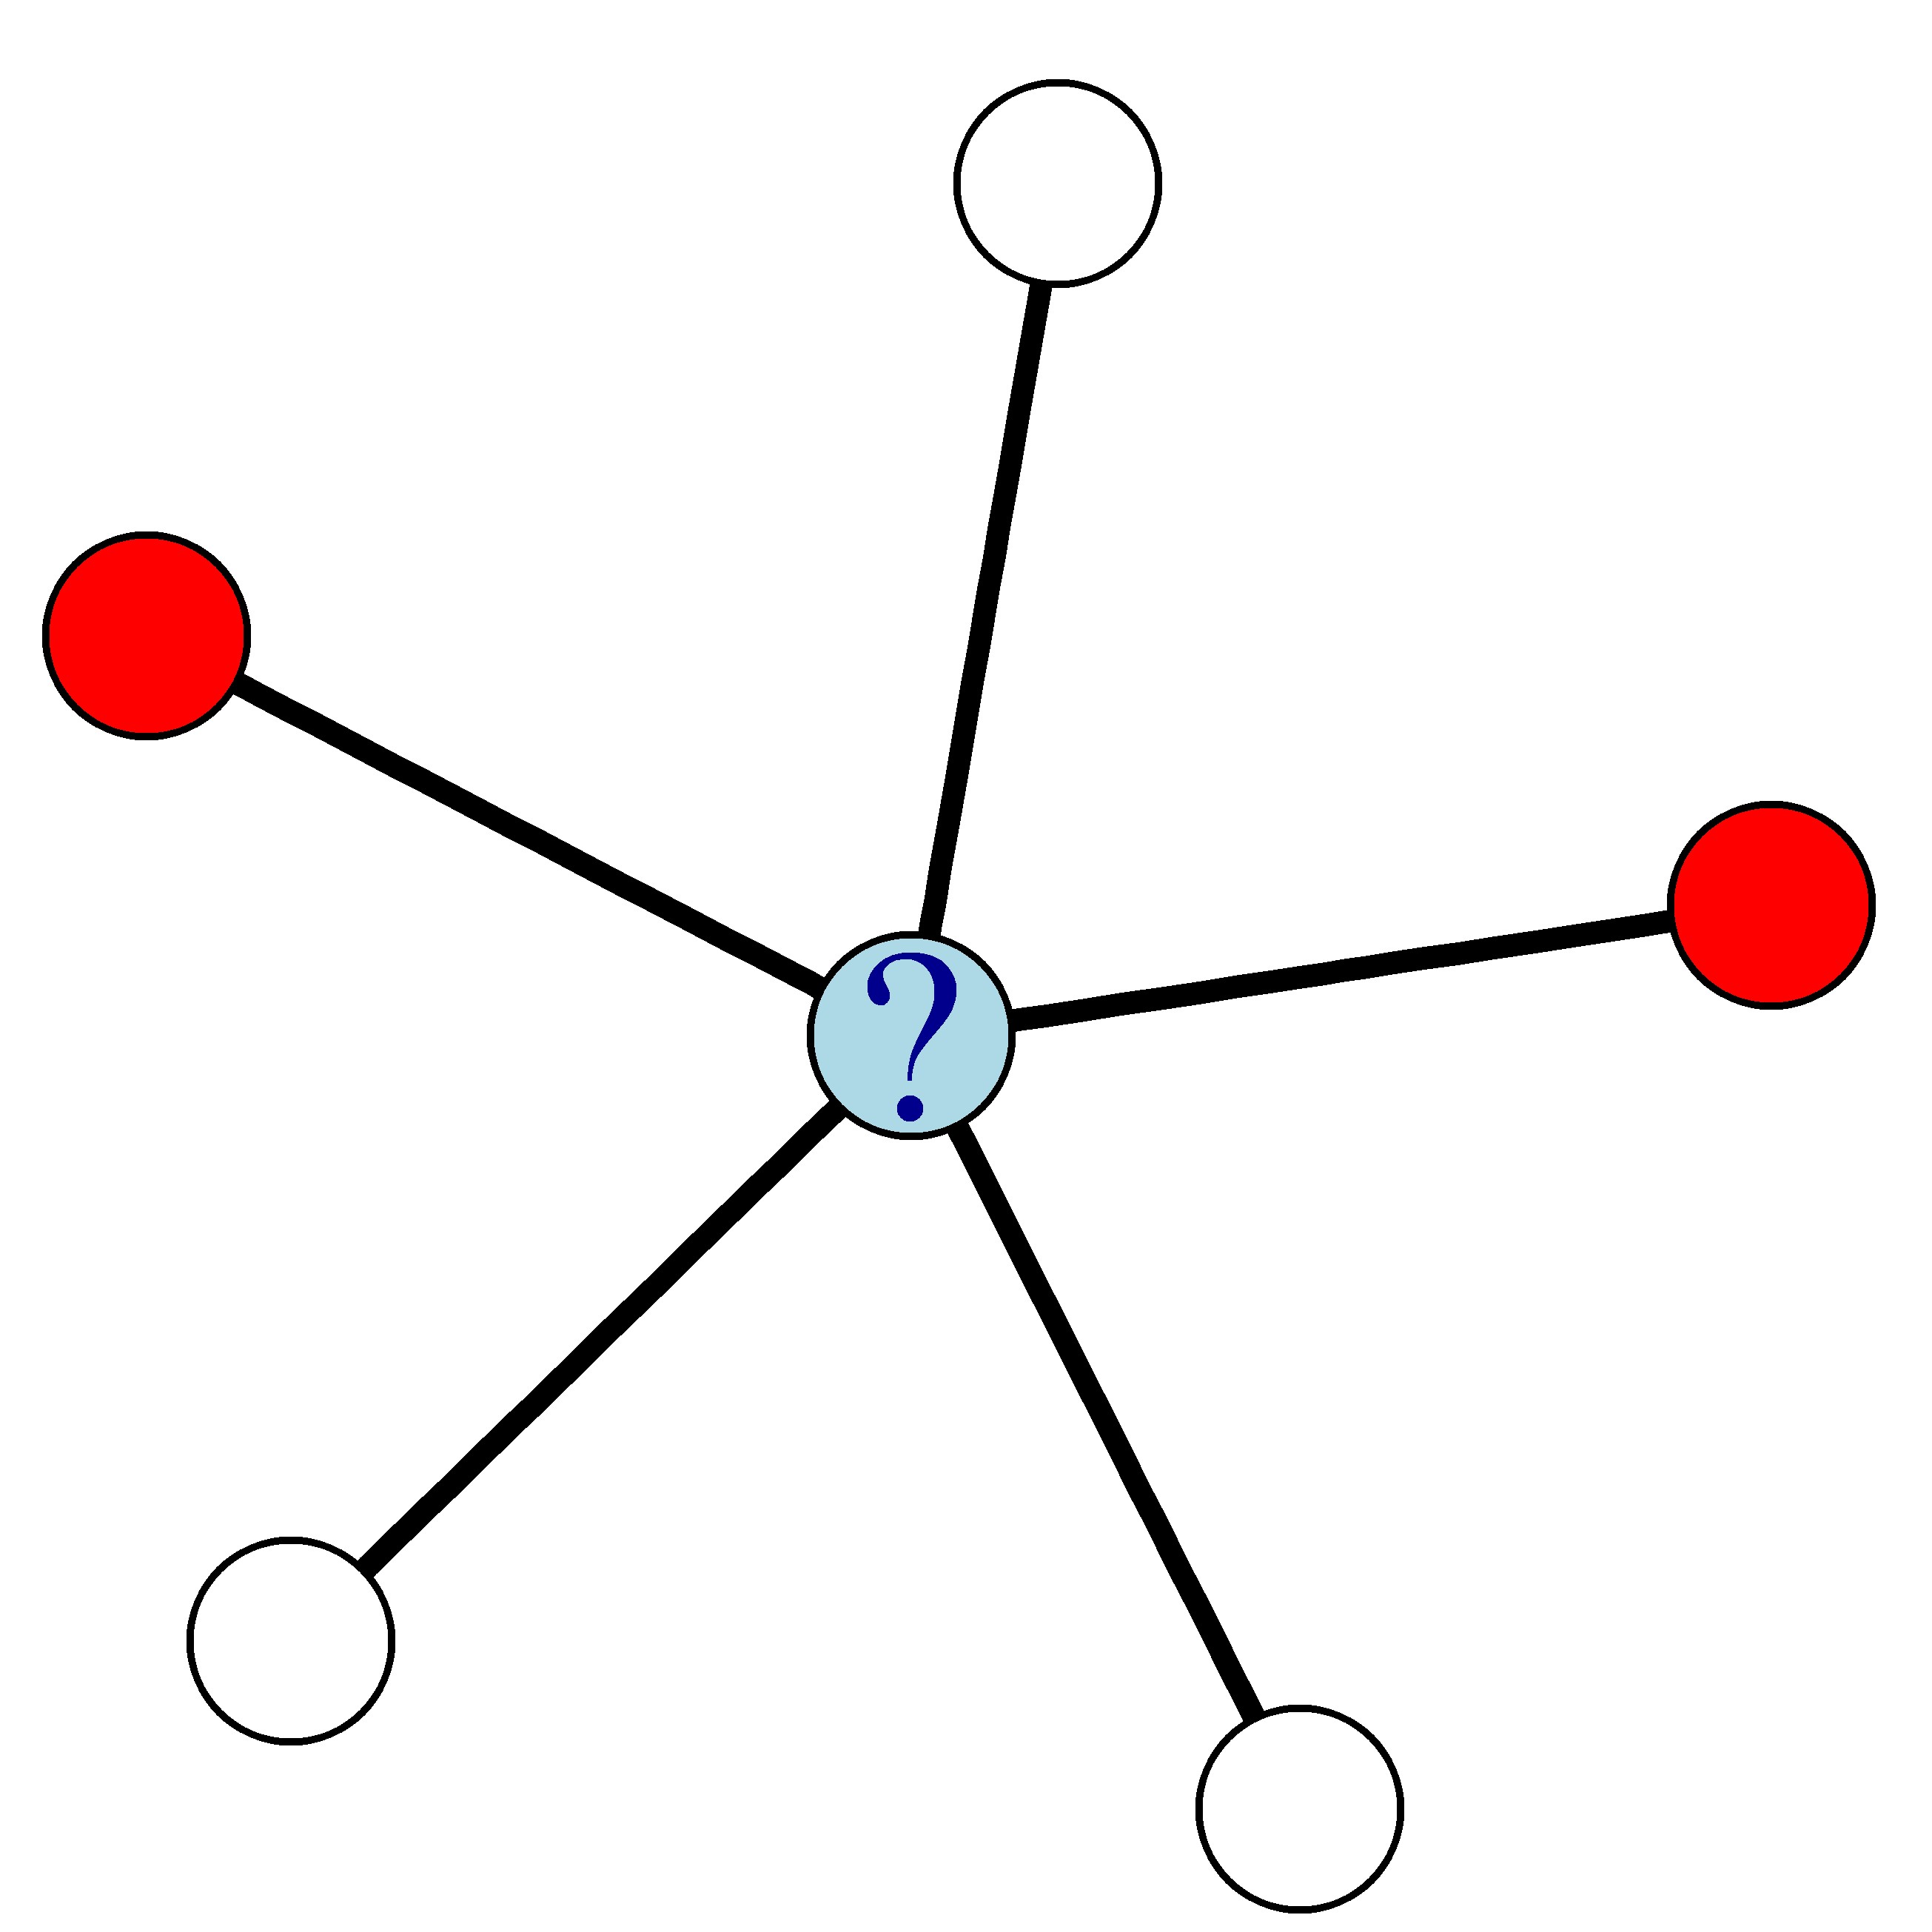
您将获得两个向量:ChurnNeighbors 和 NonChurnNeighbors,分别表示每位客户的"已流失邻居数"和"未流失邻居数"。
本练习是课程的一部分
使用 R 进行网络数据的预测分析
练习说明
- 使用关系邻居分类器计算每位客户的流失概率
churnProb。 - 使用
which()找到流失概率最高的客户,并将该向量命名为mostLikelyChurners。 - 使用
mostLikelyChurners找到这些流失概率最高客户的 ID。
交互式实操练习
通过完成这段示例代码来试试这个练习。
# Compute the churn probabilities
churnProb <- ___ / (ChurnNeighbors + ___)

# Find who is most likely to churn
mostLikelyChurners <- which(churnProb == ___(churnProb))

# Extract the IDs of the most likely churners
customers$id[___]