處理標籤雜訊
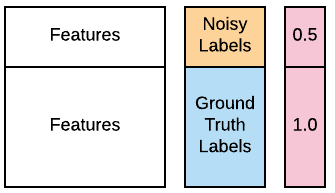
你的其中一位網安分析師告訴你,訓練資料中前 100 台來源電腦的許多標籤可能因資料庫錯誤而有誤。她希望你仍能使用這些資料,因為大多數標籤仍是正確的,但請你將這 100 個標籤視為「有雜訊」。所幸你知道如何用加權學習來處理。受污染的資料已在你的工作環境中提供為 X_train、X_test、y_train_noisy、y_test。你想看看是否能透過加權學習來提升 GaussianNB() 分類器的效能。你可以使用大多數常見分類器之 .fit() 方法所支援的選用參數 sample_weight。函式 accuracy_score() 已預先載入。你可以參考下方圖片作為指引。
本練習屬於課程
在 Python 設計機器學習工作流程
練習說明
- 使用受污染標籤的訓練資料,對
GaussianNB()的一個實例進行擬合。 - 使用
accuracy_score()回報其在測試資料上的準確率。 - 建立權重,讓真實標籤的權重是雜訊標籤的 2 倍。記住,權重是針對訓練資料。
- 依上述權重重新擬合分類器,並回報其準確率。
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Fit a Gaussian Naive Bayes classifier to the training data
clf = ____.____(____, y_train_noisy)

# Report its accuracy on the test data
print(accuracy_score(y_test, ____.____(X_test)))

# Assign half the weight to the first 100 noisy examples
weights = [____]*100 + [1.0]*(len(____)-100)

# Refit using weights and report accuracy. Has it improved?
clf_weights = GaussianNB().fit(X_train, y_train_noisy, ____=____)
print(accuracy_score(y_test, ____))