Clipped surrogate 目標函式
為 PPO 實作 calculate_loss() 函式。這需要你撰寫 PPO 的關鍵創新──clipped surrogate 損失函式。它能限制策略更新的幅度,避免每一步與前一個策略差太多。
clipped surrogate 目標的公式如下:
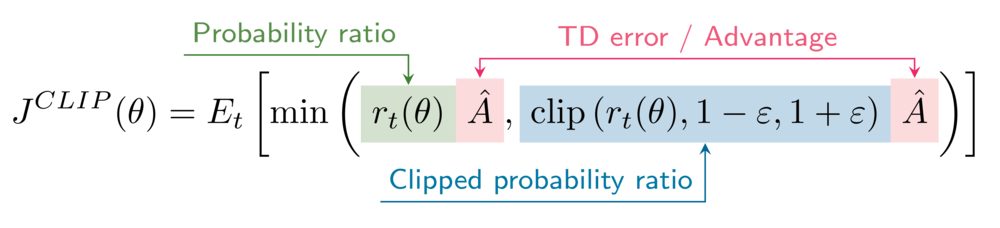
你的環境中,裁切的超參數 epsilon 設為 0.2。
本練習屬於課程
Python 的深度強化學習
練習說明
- 取得
\pi_\theta與\pi_{\theta_{old}}的機率比例(未裁切與已裁切版本)。 - 計算代理目標(未裁切與已裁切版本)。
- 計算 PPO 的 clipped surrogate 目標。
- 計算 actor 的損失。
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
def calculate_losses(critic_network, action_log_prob, action_log_prob_old,
                     reward, state, next_state, done):
    value = critic_network(state)
    next_value = critic_network(next_state)
    td_target = (reward + gamma * next_value * (1-done))
    td_error = td_target - value
    # Obtain the probability ratios
    ____, ____ = calculate_ratios(action_log_prob, action_log_prob_old, epsilon=.2)
    # Calculate the surrogate objectives
    surr1 = ratio * ____.____()
    surr2 = clipped_ratio * ____.____()
    # Calculate the clipped surrogate objective
    objective = torch.min(____, ____)
    # Calculate the actor loss
    actor_loss = ____
    critic_loss = td_error ** 2
    return actor_loss, critic_loss

actor_loss, critic_loss = calculate_losses(critic_network, action_log_prob, action_log_prob_old,
                                           reward, state, next_state, done)
print(actor_loss, critic_loss)