訓練 REINFORCE 演算法
現在你已經可以用 REINFORCE 來訓練 Lunar Lander!你需要完成的是實作 REINFORCE 的訓練迴圈,包括 REINFORCE 的損失計算。
由於損失計算會橫跨內層與外層迴圈,這次你不會使用 calculate_loss() 函式。
當一個回合結束時,你可以用這兩個量來計算損失。
供你參考,以下是 REINFORCE 損失函式的表示式:
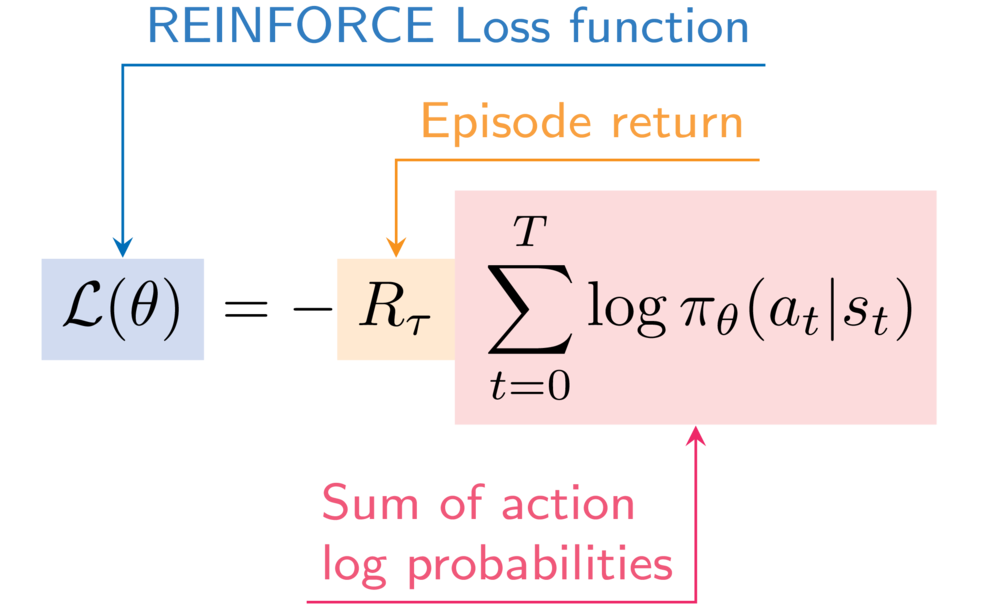
你會再次使用 describe_episode() 函式,在每個回合列印代理在該回合的表現。
本練習屬於課程
Python 的深度強化學習
練習說明
- 將所選動作的對數機率加入回合的對數機率序列。
- 以當前步驟的折扣報酬遞增回合總回報。
- 計算 REINFORCE 的回合損失。
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
for episode in range(50):
    state, info = env.reset()
    done = False
    episode_reward = 0
    step = 0
    episode_log_probs = torch.tensor([])
    R = 0
    while not done:
        step += 1
        action, log_prob = select_action(policy_network, state)
        next_state, reward, terminated, truncated, _ = env.step(action)
        done = terminated or truncated
        episode_reward += reward
        # Append to the episode action log probabilities
        episode_log_probs = torch.cat((____, ____))
        # Increment the episode return
        R += (____ ** step) * ____
        state = next_state
    # Calculate the episode loss
    loss = ____ * ____.sum()
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    describe_episode(episode, reward, episode_reward, step)