使用 spaCy 進行文字處理
每個 NLP 應用都由多個文字處理步驟組成。你已經學過其中一些步驟,例如分詞(tokenization)、詞形還原(lemmatization)、句子切分(sentence segmentation)以及命名實體辨識(named entity recognition)。
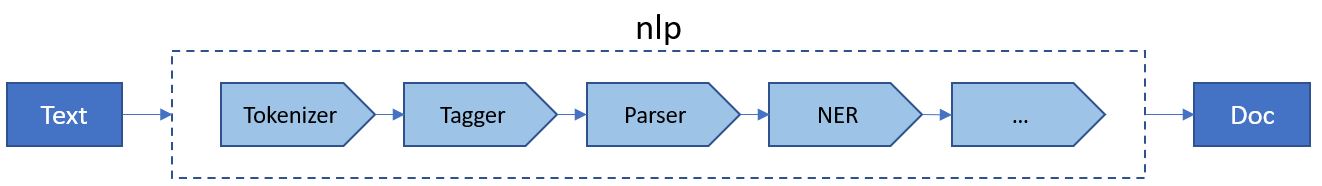
在這個練習中,你會繼續練習 spaCy 的文字處理步驟,例如將文字切成句子,並抽取命名實體。這裡會使用 Amazon Fine Food Reviews 資料集中的前 5 則評論。你可以透過 texts 物件取得這些評論。
en_core_web_sm 模型已為你載入,可由 nlp 存取。documents 也已預先建立,包含 texts 中每個項目的 Doc 容器清單。
本練習屬於課程
使用 spaCy 的自然語言處理
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Create a list to store sentences of each Doc container in documents
sentences = [[____ for sent in doc.____] for doc in documents]

# Print number of sentences in each Doc container in documents
num_sentences = [len(____) for s in sentences]
print("Number of sentences in documents:\n", ____)