Добавьте Spark в свои данные
В предыдущем упражнении вы узнали, как перенести данные из Spark в pandas. Но что если нужно сделать обратное — загрузить pandas DataFrame в кластер Spark? Класс SparkSession предоставляет и такую возможность.
Метод .createDataFrame() принимает pandas DataFrame и возвращает Spark DataFrame.
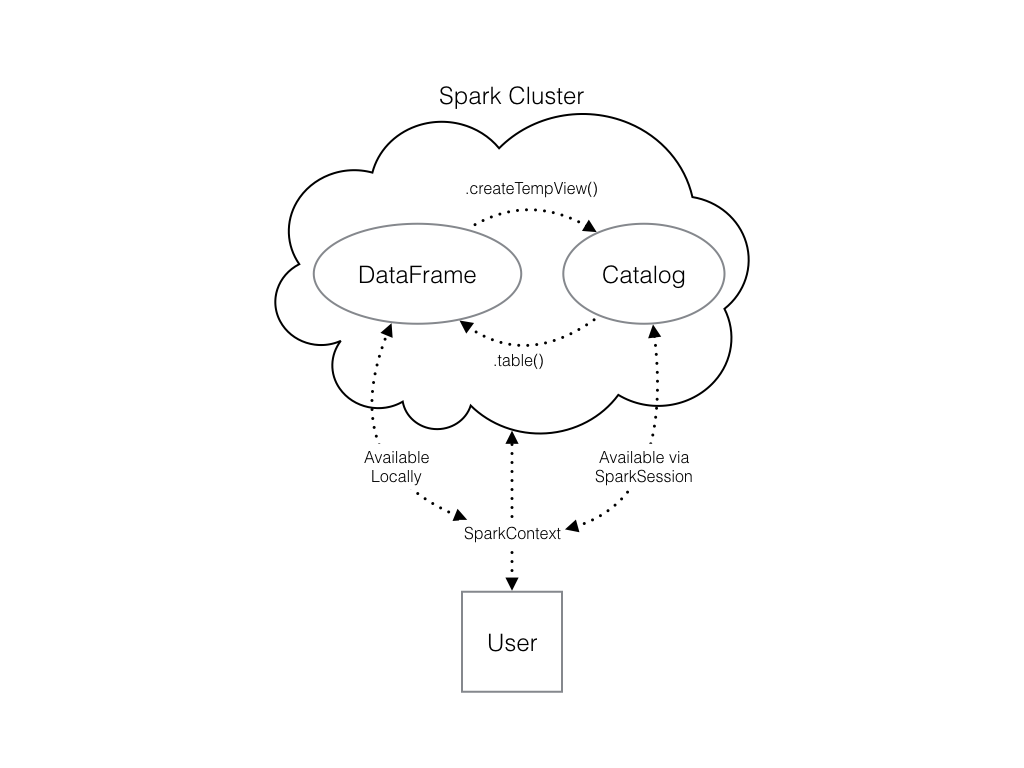
Результат этого метода хранится локально, а не в каталоге SparkSession. Это означает, что вы можете применять к нему все методы Spark DataFrame, однако обратиться к этим данным из других контекстов не получится.
Например, SQL-запрос (с помощью метода .sql()), обращающийся к вашему DataFrame, вызовет ошибку. Чтобы получить доступ к данным таким способом, их нужно сохранить как временную таблицу.
Для этого используется метод .createTempView() объекта Spark DataFrame. Он принимает единственный аргумент — имя временной таблицы, которую вы хотите зарегистрировать. Метод регистрирует DataFrame как таблицу в каталоге, однако, поскольку таблица является временной, она доступна только в рамках конкретной SparkSession, в которой был создан Spark DataFrame.
Существует также метод .createOrReplaceTempView(). Он безопасно создаёт новую временную таблицу, если она ещё не существует, или обновляет уже имеющуюся. Вы будете использовать именно этот метод, чтобы избежать проблем с дублированием таблиц.
Обратитесь к схеме, чтобы увидеть все способы взаимодействия структур данных Spark между собой.
В рабочем пространстве уже создан объект SparkSession с именем spark, библиотека numpy импортирована как np, а pandas — как pd.
Это упражнение является частью курса
Основы PySpark
Инструкции к упражнению
- Код для создания
pandasDataFrame из случайных чисел уже написан и сохранён в переменнойpd_temp. - Создайте Spark DataFrame с именем
spark_temp, вызвав метод Spark.createDataFrame()и передавpd_tempв качестве аргумента. - Проверьте список таблиц в вашем кластере Spark и убедитесь, что новый DataFrame не отображается в нём. Для этого используйте
spark.catalog.listTables(). - Зарегистрируйте только что созданный DataFrame
spark_tempкак временную таблицу с помощью метода.createOrReplaceTempView(). Временная таблица должна называться"temp". Помните, что имя таблицы передаётся как единственный аргумент метода. - Снова проверьте список таблиц.
Интерактивное практическое упражнение
Попробуйте выполнить это упражнение, дополнив этот пример кода.
# Create pd_temp
pd_temp = pd.DataFrame(np.random.random(10))

# Create spark_temp from pd_temp
spark_temp = ____

# Examine the tables in the catalog
print(____)

# Add spark_temp to the catalog
spark_temp.____

# Examine the tables in the catalog again
print(____)