影像張量
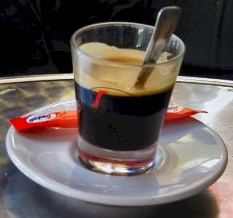
某家咖啡公司正在進行物件偵測專案,需要標註感興趣的物件,本例為濃縮咖啡(espresso)液柱。你已經為一張濃縮咖啡影像建立了一個包含邊界框座標的清單。現在,你需要把影像與這些座標都轉換為張量。
已匯入 torch 與 torchvision。torchvision.transforms 以 transforms 名稱匯入。影像已使用 PIL 函式庫的 Image.open() 載入為 image。邊界框座標已儲存在變數 bbox 中。
本練習屬於課程
使用 PyTorch 進行影像深度學習
練習說明
- 使用
torch.tensor()將bbox轉換為張量。 - 使用
unsqueeze(0)為bbox_tensor新增一個批次維度以重新塑形。 - 建立一個 transform,將
image調整大小為(224),並轉換為未縮放的影像張量。 - 對
image套用transform。
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Convert bbox into tensors
bbox_tensor = ____

# Add a new batch dimension
bbox_tensor = bbox_tensor.____

# Resize image and transform tensor
transform = transforms.Compose([
  transforms.____,
  transforms.____
])

# Apply transform to image
image_tensor = ____
print(image_tensor)