建立語意遮罩
進行全景式分割的一個常見做法,是將語意分割與實例分割的輸出結合起來。請看以下這張紐約街道的影像。
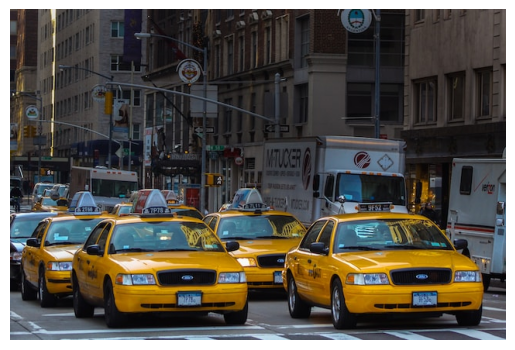
你的任務是做全景式分割,讓每一台計程車都被辨識為不同的物件,同時能分出柏油路面與建築物這兩種背景。
為了達成這個目標,你會先用一個已訓練好的 U-Net(以 UNet() 提供)產生語意遮罩。理想情況下,它應該能區分兩種背景類型(但不會分出各別的計程車)!
本練習屬於課程
使用 PyTorch 進行影像深度學習
練習說明
- 以
model來建立 U-Net 模型實例。 - 將輸入影像張量傳入模型,產生
semantic_masks。 - 透過為每個像素選擇機率最高的類別,建立單一語意遮罩。
動手互動練習
試著完成這個範例程式碼,體驗一下這個練習。
# Instantiate the model
model = ____

# Produce semantic masks for the input image
with torch.no_grad():
    semantic_masks = ____

# Choose highest-probability class for each pixel
semantic_mask = ____(____, ____)

# Display the mask
plt.imshow(semantic_mask.squeeze(0))
plt.axis("off")
plt.show()